一张录音卡背后我们死磕了两件难的事
艾视智能AI录音卡·转写与说话人身份技术实践
录音这件事,硬件解决的是“录得到”。但真正决定一块录音卡好不好用的,是录完之后:这段话究竟是谁说的、公司内部的专有名词有没有写错、同一场会用几台设备录下来的文件能不能拼成一份完整的会议记录。
这几件事没一件是“接个语音大模型”就能自动解决的。这段时间我们把整套后端服务从零搭到可交付,最后收敛下来,其实只做实了两件事:让机器听得准,以及让机器认得人。这篇文章只讲技术怎么做、怎么测,不讲参数表。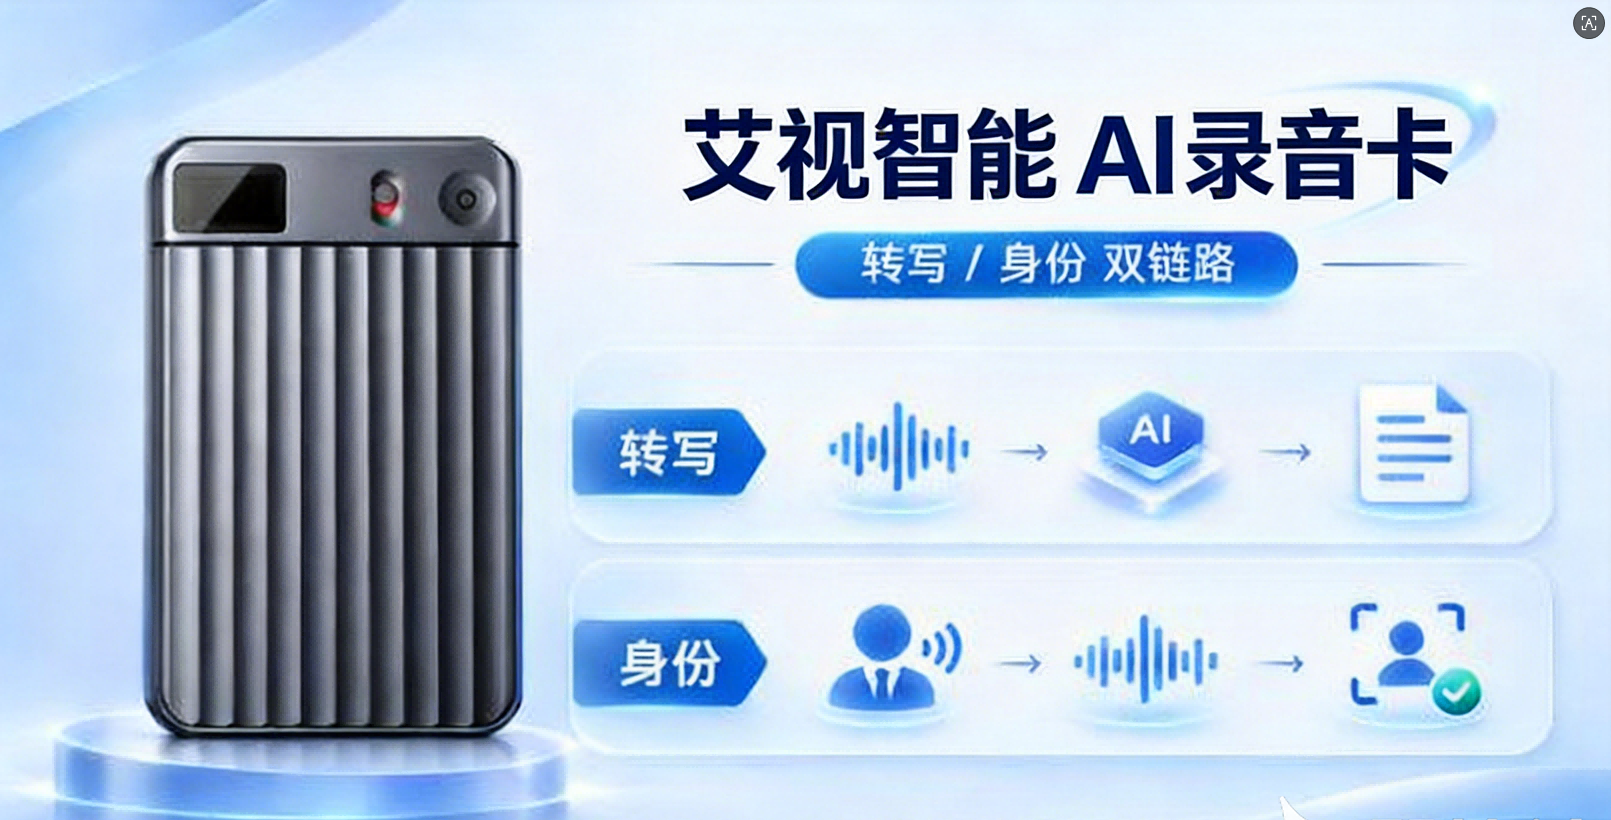
艾视智能 AI 录音卡,转写/身份双链路示意图
01 为什么偏偏是这两件事
第一个痛点是“能出字,但没法直接用”。真实录音不是实验室里的干净WAV:手机远场是16k单声道AAC还带电话带通,笔记本内置麦是44.1k立体声加混响,会议室远端设备往往还叠了噪声和-8dB的衰减;一场会动辄几十分钟,专有名词、产品代号、人名一旦写错,整段记录就得人工重修。
第二个痛点更隐蔽,也更折磨人:同一个人,在不同文件里被标成了不同编号;或者两个不同的人,被合并成同一个。客户把几支录音笔、几台电脑的音频导出来一合并,说话人全乱了。对会议记录来说,这比错几个字严重得多——谁承诺了什么、谁拍的板,全靠这个标签。
所以我们的判断是:录音卡的产品分水岭,不在录音,而在转写结果能不能直接进工作流。听不准和认不出人,是挡在中间的两道墙。
02 第一件事:让转写从“能出字”变成“能直接用”
引擎与链路
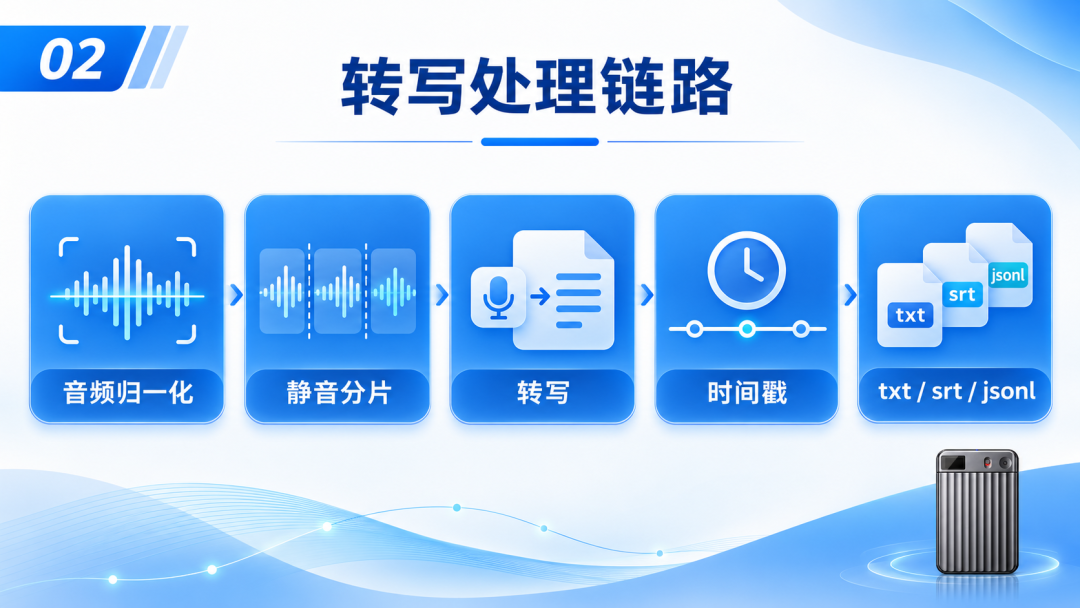
推理内核用 Qwen3-ASR-1.7B,词级/字级时间戳由 ForcedAligner-0.6B 提供。所有输入先经过 ffprobe 探测与 ffmpeg 归一化,统一到 16kHz 单声道;长音频按“静音点优先、固定窗口兜底”分片,规避 token 上限与对齐器的时长限制,结果再拼回完整时间轴。输出侧同时给纯文本、JSONL、SRT,并提供 OpenAI 兼容接口,老系统不用改造就能接入。
这里有个容易被忽略的细节:官方 context 参数接受字符串或字符串列表,但列表是按音频样本广播的,不是“词表列表”。我们一开始按直觉传了数组,热词完全不生效;后来把词表拼成单个字符串写进 system message,偏置才真正起作用。这类坑不踩一遍,文档上是看不出来的。
热词要能运营,不是能配置
我们做了两层:每请求动态传私有词汇,以及命名热词集(按客户、部门、项目、会议切换)。关键是改词库不用重启服务——实测更新前后进程 uptime 从 582.3s 到 582.7s,词表即时生效。每次变更写不可变版本快照,可按 revision 回溯,并落审计日志。会议纪要里一个产品名错了,运营改词表就能修,不需要重新训练,也不需要发版。
A/B 实测很直观:基线把「通义千问」写成「通一千问」、「Qwen3-ASR」写成「Queen 三 ASR」;挂上热词后,两处都纠正为正确写法。
效果落在数字上
· 短音频平均 RTF 0.0939(约10倍实时);6分钟音频 RTF 0.013,端到端4.7秒处理完,且是分片覆盖整段,不是只取开头。
· 11个格式用例、8kHz到192kHz的采样率与多种位深/声道布局、0.3秒到6分钟的时长档位,全部通过。
· 连续20次请求20/20成功;并发1/2/4全部成功;显存峰值12,785MiB,稳在一张16GB显卡内。
· 公网真实下载的34个音频、合计85.37MB(最大17.79MB、最长348秒、最高192kHz/64bit),33个有效样本33/33符合预期。
03 第二件事:不只是“有几个说话人”,而是“这几个人是谁”
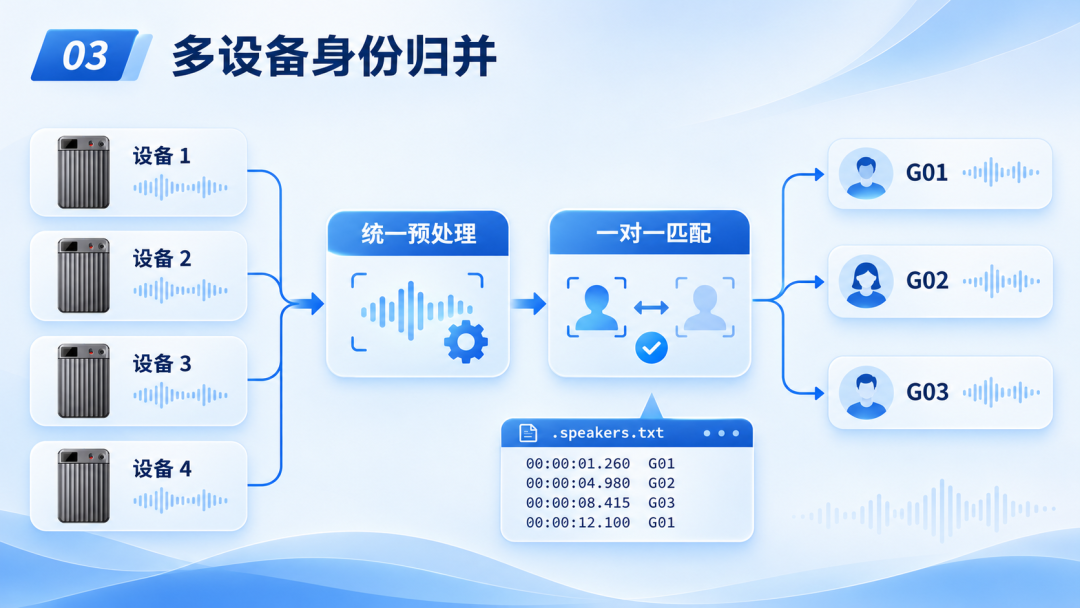
多设备身份归并示意图——设备1/2/3/4 → 统一预处理 → 一对一匹配 → G01/G02/G03]
先说一个我们没接受的捷径。现在有一类端到端模型,一次推理就能同时吐出转写、时间戳和说话人标签。我们接入了 OpenMOSS 的 MOSS-Transcribe-Diarize(经 FunASR 的 AutoModel 以 backend="hf" 运行),输出形如 [0.35][S01]……[3.77],确实优雅。但按官方语义,这里的 [S01] 只是单次录音内的匿名标签:它不认识张经理是谁,也不保证同一人在第二个文件里还是 S01。
如果直接把它当“说话人识别”卖给客户,多设备合并时必然翻车。所以我们的选择不是替换,而是分层:
· 文件内交给 MOSS / CAM++ 做分离与对齐,负责“谁在什么时候说话”;
· 跨文件身份交给独立的声纹层,负责“这个人在所有文件里都是同一个 ID”。两个后端通过统一的 DiarizeBackend 接口并存,worker 不可达时自动回退到本地 CAM++,主链路不中断。两套依赖对 transformers 的版本要求冲突(4.57.6 与 5.22.2),我们用双容器边界隔离,谁也不污染谁。顺带踩过一个坑:FunASR sentence_info 里的时间戳单位是毫秒,早期没换算,整条时间轴错了1000倍。
跨文件一致性具体怎么做
所有设备文件先统一到16k单声道并做响应归一,但保留首尾边界不裁剪静音——否则不同设备的时长会漂移,时间轴对不齐。之后提取192维声纹 embedding,把每个文件的局部标签与全局 ID 做最大化总相似度的一对一匹配,并把“这场会有几个人”作为先验传进去。双门限(0.72 / 0.55)判定:高置信直接绑定,低置信仍复用既有 ID、只打上待复核标记,绝不轻易新开一个 ID——这正是“同人异 ID”的根源。同时设了合并上限,防止过度合并把两个不同的人并成一个。
在此之上,才谈得上产品化能力:声纹注册后新文件自动回填姓名;人工校正一次写回声纹质心,后续文件自动生效且全程可追溯;重叠语音给结构化标注;按说话人导出独立音轨。
多设备测试是这一层最硬的证据。我们用3位说话人、8轮对话构造母带,再模拟4种采集环境:近场麦克风、手机远场(16k/AAC/-10dB/电话带通/轻噪声)、笔记本内置麦(44.1k/立体声/MP3/+5dB/混响)、会议室远端(16k/-8dB/带通+混响+噪声)。四个文件的说话人、语序、内容完全相同,只有设备环境不同,精确复现客户描述的痛点。
结果:
· 4个文件在同一会话下全部得到 G01/G02/G03,逐轮次与真值吻合;consistency_rate = 1.0、identity_stability = 1.0、全局身份数3、待复核0。
· 统一预处理后时长 48.88→48.88 / 48.88 / 48.94 / 48.97 秒,边界没有被吞掉。
· 另做留出集:第5台设备、全新台词,注册声纹后自动输出 [G01张经理][G02李总][G03王工]——证明认的是声纹,不是背台词。
· 45秒双人音频,分离耗时1.58秒,转写+分离合计2.455秒;分离后端跑在 CPU,同音频 A/B 配对显存增量 △0MiB。
· 21个ASR片段21/21带说话人标签,未归属片段0,无兜底 S00。
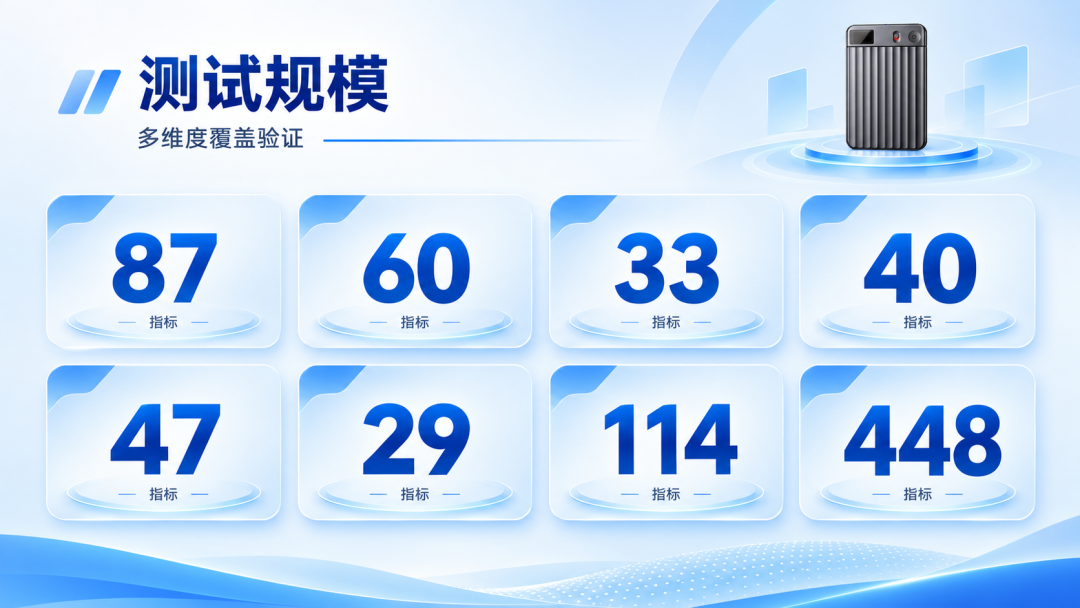
技术发声最容易滑向“跑通即发布”。我们给自己定的规矩是:不拿健康检查凑数,每一组都用真实音频打业务接口,校验响应内容和落盘文件,失败项如实留证。
分阶段累计如下(各套件为独立断言,不是同一批重复跑):
| 测试套件 | 结果 |
| 单元测试 | 87项 OK |
| 一期全量验收 | 60 PASS / 0 FAIL(格式、信号、时长、内容、异常、并发、稳定性、显存) |
| 公网真实下载音频 | 33 / 33 PASS(1个下载失败样本如实跳过,不进步 |
| 热词与说话人分离专项 | 40 PASS / 0 FAIL |
| 二期(跨文件身份 / MOSS组合) | 47 PASS / 0 FAIL |
| Docker 双容器业务验收 | 29 PASS / 0 FAIL(单文件转写、热词 A/B、多人识别、声纹注册四类必测 |
| AI 可读 API 契约回归 | 114 PASS / 0 FAIL(逐端点真实请求 + schema 逐字段校验 |
| 独立 Python / JavaScript 客户端直连演示 | 各 19 PASS / 0 FAIL |
合计 448 项断言/用例,0 失败。二期与 Docker 验收报告里,我们把4台设备逐轮次的 .speakers.txt 原文直接贴进了报告,每一行带全局 ID 与台词,可以逐行对真值,而不是只给一个“准确率99%”的结论。
契约这块也值得单独说一句:服务端自动生成的 /openapi.json 里,4个 POST 路由全部是 params=0 / body=no,业务 schema 只剩两个框架错误类型——因为路由层是手工解析 multipart/JSON 的。拿它去给 AI 生成客户端,一定会生成不能用的代码。我们基于74例现网真实请求/响应手工补全了一份 OpenAPI 3.1(12 paths / 16 operations / 34 schemas / 34 错误码 / 双鉴权方案),并用114项回归把它钉住。能被 AI 直接读、直接对接,本身就是交付质量的一部分。